Les outils d’intelligence artificielle sont aujourd’hui capables de recommander des produits, de prévoir des ventes, de reconnaître des images ou de rédiger des textes. Derrière cette diversité d’applications se cachent pourtant des technologies assez différentes, dont les mécanismes, les possibilités et les limites méritent d’être compris. Pour les découvrir, prenons un exemple qui nous accompagnera tout au long de cet article : une boutique en ligne spécialisée dans les vêtements et les équipements de randonnée. Elle souhaite conseiller ses clients dans leurs achats, anticiper ses ventes et automatiser certaines tâches, notamment la rédaction des fiches produits.
- Dans cet article
- I. Une première carte pour comprendre les familles d’intelligence artificielle
- II. L’IA symbolique : représenter des connaissances pour raisonner
- III. Le machine learning : apprendre à partir des données
- a. L’apprentissage supervisé : apprendre à partir d’exemples connus
- b. L’apprentissage non supervisé : découvrir des structures dans les données
- c. L’apprentissage par renforcement : apprendre à choisir des actions
- d. Et l’apprentissage auto-supervisé ?
- e. Apprendre ne signifie pas comprendre toutes les causes
- IV. Le deep learning : apprendre des représentations complexes
- V. L’IA générative : produire des contenus à partir de modèles appris
- VI. Dans la pratique, plusieurs approches peuvent coexister
- VII. Mon point de vue : se méfier de la fascination pour les modèles les plus puissants
Ces besoins pourraient tous être traités par des systèmes d’intelligence artificielle. Mais les solutions techniques seraient très différentes. Certaines s’appuieraient sur des règles définies par des experts, d’autres apprendraient à partir des données de l’entreprise. D’autres encore utiliseraient des réseaux de neurones capables de traiter des images ou de produire du langage. Comprendre ces distinctions permet de mieux apprécier ce que chaque technologie peut apporter et, surtout, de ne pas attribuer à tous les systèmes d’IA les mêmes capacités.
Une première carte pour comprendre les familles d’intelligence artificielle
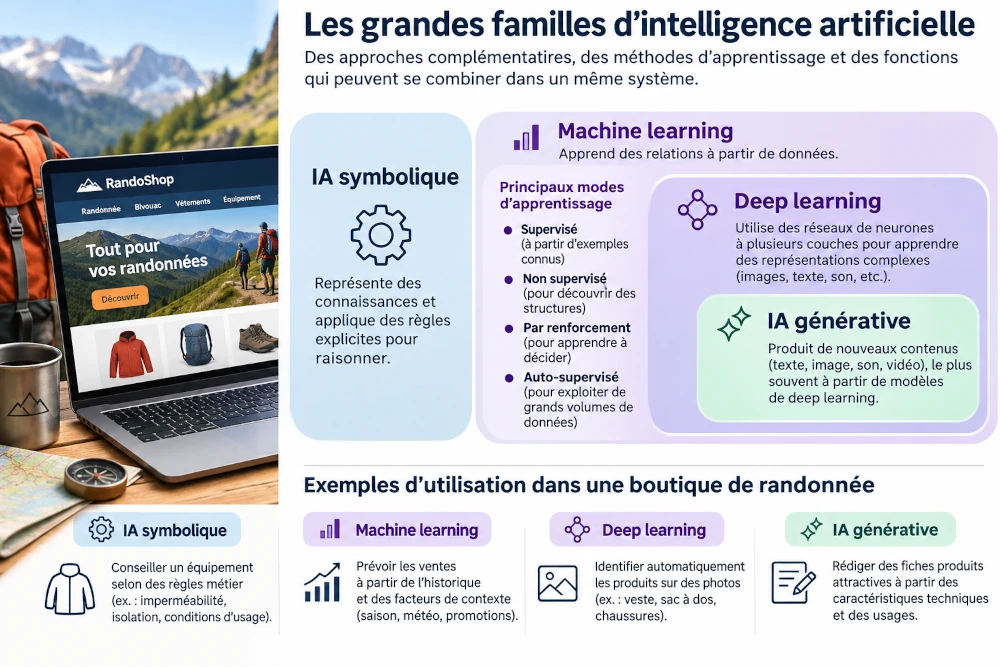
On présente souvent l’intelligence artificielle comme un ensemble de technologies emboîtées les unes dans les autres : l’IA contiendrait le machine learning, qui contiendrait le deep learning, qui contiendrait à son tour l’IA générative.
Cette représentation a le mérite de la simplicité, mais elle est inexacte. Elle mélange des notions qui ne se situent pas toutes au même niveau.
Pour s’y retrouver, nous pouvons distinguer deux grandes approches historiques de l’intelligence artificielle.
- L’IA symbolique cherche à reproduire certaines formes de raisonnement en représentant explicitement des connaissances et les règles permettant de les utiliser. Les concepteurs décrivent les éléments du problème et la manière dont le système doit les articuler.
- L’apprentissage automatique, ou machine learning, consiste à construire des modèles dont les paramètres sont ajustés à partir de données. Le système apprend des relations statistiques qui lui permettent ensuite de produire des prédictions, des classifications ou d’autres résultats.
Ces deux approches ne sont pas nécessairement concurrentes. Elles peuvent être combinées au sein d’un même système.
Deux autres notions viennent compléter cette première distinction.
- Le deep learning, ou apprentissage profond, est une branche du machine learning. Il repose sur des réseaux de neurones artificiels organisés en plusieurs couches. Son développement a considérablement amélioré les performances des systèmes d’IA dans des domaines comme la reconnaissance d’images, le traitement du langage ou l’analyse du son.
- L’IA générative, quant à elle, désigne une fonction : produire de nouveaux contenus, qu’il s’agisse de textes, d’images, de sons ou de vidéos. Les systèmes génératifs contemporains reposent très largement sur le deep learning, mais la génération de contenus n’est pas, en elle-même, une méthode d’apprentissage.
Cette distinction entre approches, méthodes et fonctions est importante. Un même réseau de neurones peut, selon son entraînement et son architecture, servir à classer des images ou à en générer de nouvelles. Inversement, une même fonction, comme recommander un produit, peut être réalisée à l’aide de techniques très différentes.
L’IA symbolique : représenter des connaissances pour raisonner
Commençons par le premier besoin de notre boutique : conseiller un client qui prépare une randonnée.
Un vendeur expérimenté connaît les caractéristiques des équipements et les conditions dans lesquelles ils sont adaptés. Il sait, par exemple, qu’une veste destinée à une marche prolongée sous la pluie doit offrir une protection imperméable. Il sait également que cette caractéristique ne garantit pas une isolation thermique suffisante pour marcher par temps froid.
Une approche consiste à formaliser ces connaissances dans un système informatique.
Des règles explicites et un moteur d’inférence
Imaginons que notre boutique dispose d’une base contenant les caractéristiques de ses produits :
- La veste A est imperméable, mais ne possède pas d’isolation thermique.
- La veste B est imperméable et isolante.
- La veste C est isolante, mais ne protège pas efficacement contre une pluie prolongée.
Le système possède également des règles de conseil :
- Si le client prévoit une marche sous une pluie prolongée, il faut rechercher une veste imperméable.
- Si le client prévoit une marche par temps froid, il faut rechercher une isolation adaptée.
Lorsqu’un client indique qu’il va randonner sous la pluie, par une température de 5 °C, le système peut appliquer ces règles aux caractéristiques du catalogue. Il détermine que la veste B satisfait les deux critères et peut donc être recommandée. Ce raisonnement est réalisé par un moteur d’inférence, un programme qui exploite les faits et les règles disponibles pour tirer des conclusions.
Les systèmes experts, qui ont connu un développement important à partir des années 1970 et 1980, reposent notamment sur ce principe. Ils ont été utilisés dans différents domaines spécialisés, comme le diagnostic de pannes, la configuration d’équipements ou l’aide au diagnostic médical.
L’IA symbolique ne se limite d’ailleurs pas aux systèmes de règles conditionnelles. Elle comprend aussi des techniques de représentation des connaissances, des logiques formelles, des graphes de connaissances et des mécanismes de planification.
Une approche explicable, mais qui dépend de la qualité des connaissances
L’intérêt d’un système fondé sur des règles explicites réside dans la possibilité de comprendre comment une conclusion a été obtenue. Si le système recommande la veste B, nous pouvons retrouver les caractéristiques du produit et les règles qui ont conduit à cette proposition. Cette propriété présente un intérêt particulier lorsque les décisions doivent être justifiées, contrôlées ou conformes à des exigences précises.
En revanche, le système ne connaît que ce qui a été formalisé. Si une propriété importante a été oubliée ou si une règle est erronée, la recommandation risque de l’être également. Il faut aussi entretenir les connaissances. À mesure que les produits, les usages et les exceptions se multiplient, la gestion d’un grand nombre de règles peut devenir difficile.
L’approche reste particulièrement pertinente lorsque les connaissances sont relativement stables et peuvent être décrites de manière explicite. Mais certains problèmes se prêtent beaucoup moins bien à cette formalisation.
Le machine learning : apprendre à partir des données
Notre boutique souhaite maintenant anticiper ses ventes afin d’adapter ses stocks. Elle dispose de plusieurs années d’historique commercial. Elle connaît les quantités vendues, les prix, les périodes de l’année, les promotions et éventuellement les conditions météorologiques.
Nous savons intuitivement que ces facteurs peuvent influencer les ventes. Mais leur effet respectif est difficile à déterminer. Une solution serait de construire un modèle mathématique capable d’apprendre les relations entre ces informations et les quantités vendues. C’est le principe du machine learning.
L’apprentissage supervisé : apprendre à partir d’exemples connus
Dans notre exemple, nous disposons de données historiques et d’un résultat à prédire : les ventes réalisées. Nous pouvons entraîner un modèle en lui présentant des exemples associant les caractéristiques d’une période aux quantités effectivement vendues. Le modèle produit une estimation, puis un algorithme ajuste ses paramètres pour réduire l’écart entre cette estimation et les ventes observées. En répétant cette opération sur de nombreux exemples, il apprend progressivement des relations statistiques.
Cette démarche correspond à l’apprentissage supervisé, dans lequel les données d’entraînement sont associées à des résultats connus, appelés étiquettes ou labels. Deux grandes familles de problèmes sont fréquemment traitées ainsi. La régression consiste à prédire une valeur numérique. Notre boutique peut chercher à prévoir la vente de 350 vestes au mois de novembre.
La classification consiste à attribuer une catégorie à une observation. Un système pourrait, par exemple, classer les demandes reçues par le service client en plusieurs catégories : livraison, retour, réclamation ou conseil produit. Les algorithmes utilisés peuvent être relativement simples, comme une régression linéaire, ou plus complexes, comme les forêts aléatoires et certains réseaux de neurones.
La complexité technique n’est d’ailleurs pas une garantie de performance. Pour prévoir des ventes à partir de quelques variables bien comprises, un modèle statistique relativement simple peut donner des résultats tout à fait satisfaisants.
L’apprentissage non supervisé : découvrir des structures dans les données
Imaginons maintenant que notre boutique souhaite mieux comprendre le comportement de ses clients. Elle possède des informations sur leurs achats, mais ne dispose pas de catégories préétablies permettant de distinguer différents profils de consommateurs. Elle pourrait utiliser une méthode de clustering, qui consiste à regrouper des observations présentant des caractéristiques similaires.
L’algorithme pourrait, par exemple, faire apparaître plusieurs groupes de clients : certains achètent régulièrement des équipements techniques coûteux, d’autres privilégient les produits d’entrée de gamme, tandis qu’un troisième groupe réalise des achats saisonniers. Nous sommes ici dans le domaine de l’apprentissage non supervisé. Le modèle recherche des structures dans les données sans disposer, au départ, des catégories qu’il devrait retrouver.
Il faut toutefois être prudent dans l’interprétation des résultats. Les groupes identifiés dépendent des variables retenues et des critères mathématiques utilisés pour mesurer les ressemblances. Un algorithme peut parfaitement identifier quatre groupes de clients sans que ceux-ci correspondent à quatre segments commerciaux pertinents.
Le travail d’analyse reste indispensable pour donner un sens aux regroupements obtenus.
L’apprentissage par renforcement : apprendre à choisir des actions
Une troisième approche mérite d’être distinguée : l’apprentissage par renforcement, ou reinforcement learning. Cette fois, le problème consiste à apprendre à prendre des décisions dans un environnement, en fonction des conséquences des actions précédentes.
Supposons que notre boutique souhaite optimiser progressivement les recommandations affichées aux visiteurs. Le système pourrait expérimenter différentes stratégies, observer les réactions des clients et utiliser ces informations pour améliorer ses décisions futures. Dans ce cadre, un agent choisit des actions et reçoit un signal de récompense associé à leurs conséquences. L’objectif est d’apprendre une stratégie, appelée politique, qui maximise les récompenses attendues au fil du temps.
C’est le cadre théorique présenté notamment par Richard Sutton et Andrew Barto dans leur ouvrage de référence Reinforcement Learning: An Introduction (2018).
Une difficulté apparaît immédiatement : comment définir une bonne récompense ? Si nous récompensons uniquement les clics sur les produits recommandés, le système pourrait apprendre à privilégier les articles qui attirent l’attention, sans nécessairement améliorer la satisfaction des clients ou la rentabilité de l’entreprise. L’apprentissage par renforcement est particulièrement intéressant pour des problèmes de décision séquentielle, dans lesquels les actions influencent les situations futures. Mais sa mise en œuvre peut nécessiter beaucoup d’expérimentations et des mécanismes de contrôle adaptés.
Pour une boutique de taille modeste, des tests comparatifs et des méthodes de recommandation plus simples peuvent être largement suffisants.
Et l’apprentissage auto-supervisé ?
Une autre approche a pris une importance considérable avec le développement des grands modèles d’IA : l’apprentissage auto-supervisé (self-supervised learning). Son principe consiste à créer une tâche d’apprentissage à partir de la structure même des données, sans nécessiter que chaque exemple ait été annoté par un humain. Un modèle de langage peut ainsi apprendre à prédire la suite d’un texte à partir des mots précédents. Les exemples d’entraînement sont produits à partir des textes eux-mêmes.
Cette méthode a contribué au développement des grands modèles de langage, car elle permet d’exploiter des quantités considérables de données sans devoir les faire annoter individuellement. Elle illustre également les limites des classifications trop rigides du machine learning. Les approches d’apprentissage sont nombreuses et peuvent être combinées pendant les différentes phases d’entraînement d’un même modèle.
Apprendre ne signifie pas comprendre toutes les causes
Revenons à notre modèle de prévision des ventes. Imaginons qu’une veste se soit très peu vendue pendant plusieurs semaines, alors qu’elle était régulièrement en rupture de stock. Si le système ignore cette information, il peut interpréter les faibles ventes comme le signe d’une demande insuffisante. Il risque alors de recommander des stocks encore plus faibles, ce qui pourrait aggraver le problème.
Cet exemple illustre une limite fondamentale de l’apprentissage statistique : un modèle peut apprendre correctement les relations présentes dans les données tout en produisant des conclusions inadaptées à la réalité du problème. Il faut donc évaluer les performances du modèle sur des données qui n’ont pas servi à son entraînement. Dans une prévision commerciale, on peut notamment conserver des périodes récentes pour tester la capacité du système à prévoir des ventes futures.
La qualité du résultat dépend autant de la définition du problème et de la pertinence des données que de l’algorithme utilisé.
Le deep learning : apprendre des représentations complexes
Notre boutique souhaite maintenant automatiser une partie du traitement de son catalogue. Elle reçoit des photographies de produits et voudrait identifier automatiquement les vestes, les sacs à dos, les chaussures ou les tentes. Pour une personne, cette tâche semble assez simple. Mais il serait particulièrement compliqué d’écrire toutes les règles permettant de reconnaître ces objets dans des conditions différentes.
Une veste peut être photographiée à plat, portée par un mannequin ou partiellement cachée. Sa couleur, sa forme et son apparence peuvent varier considérablement.
Le rôle des réseaux de neurones
L’apprentissage profond repose sur des réseaux de neurones artificiels comprenant plusieurs couches de calcul. Chaque couche transforme les informations reçues pour produire de nouvelles représentations, qui peuvent ensuite être exploitées par les couches suivantes. Dans certains réseaux destinés à analyser des images, les premières couches peuvent apprendre à détecter des motifs visuels simples, tandis que d’autres construisent des représentations progressivement plus complexes.
L’un des apports majeurs du deep learning réside dans cette capacité à apprendre les caractéristiques utiles à la réalisation d’une tâche, plutôt que de dépendre exclusivement de caractéristiques définies au préalable par les concepteurs. Ce principe est développé dans l’ouvrage Deep Learning de Ian Goodfellow, Yoshua Bengio et Aaron Courville (MIT Press, 2016), qui constitue une référence importante sur le sujet.
Le deep learning a notamment permis des progrès considérables dans le traitement des images, du langage, de la parole et de nombreuses données complexes.
Des performances remarquables, mais pas une solution universelle
Les réseaux profonds ne sont pas systématiquement préférables aux autres méthodes. Ils peuvent nécessiter d’importantes ressources de calcul, des données adaptées et des compétences techniques pour l’entraînement ou l’adaptation des modèles. Pour notre boutique, reconnaître les produits présents sur des milliers de photographies pourrait justifier l’utilisation d’un modèle profond déjà entraîné.
En revanche, construire un réseau de neurones complexe pour appliquer une règle de livraison ou calculer une remise commerciale serait probablement une complication inutile. Il existe également des limites propres aux informations disponibles. Reconnaître visuellement une veste ne permet pas de connaître avec certitude son imperméabilité. Un modèle peut identifier son apparence, mais une propriété technique comme la résistance à une colonne d’eau de 20 000 mm doit être obtenue à partir de données appropriées, généralement fournies par le fabricant.
Cette distinction entre ce qu’un système sait reconnaître et ce qu’il peut effectivement établir est essentielle lorsqu’on utilise l’IA pour produire des informations destinées aux clients.
L’IA générative : produire des contenus à partir de modèles appris
Notre boutique souhaite enfin automatiser la rédaction de ses fiches produits. Pour chaque veste, elle possède une description technique comprenant les matériaux, le poids, les performances d’imperméabilité et les caractéristiques d’utilisation. Elle aimerait transformer ces informations en un texte commercial clair et agréable à lire. Cette tâche peut être confiée à un système d’IA générative, capable de produire un contenu à partir d’une consigne et des informations disponibles.
Comment fonctionne un modèle de langage ?
Les grands modèles de langage, ou Large Language Models (LLM), reposent généralement sur des architectures de réseaux de neurones appelées Transformers. Au cours d’une phase importante de leur entraînement, ces modèles apprennent notamment à prédire des unités de texte, appelées tokens, en fonction de leur contexte. Cette tâche apparemment simple permet d’apprendre des régularités extrêmement complexes du langage, ainsi que de nombreuses relations présentes dans les textes utilisés pendant l’entraînement.
L’entraînement peut ensuite être complété par différentes méthodes d’ajustement destinées à améliorer la capacité du modèle à suivre des instructions et à produire des réponses adaptées. Lorsqu’on lui demande de rédiger une fiche produit, le modèle génère progressivement un texte en tenant compte de la consigne, du contexte disponible et des régularités apprises. Le résultat peut être remarquablement fluide, y compris lorsque la demande est complexe.
La production d’un texte plausible ne garantit pas son exactitude
Imaginons que notre boutique transmette au modèle les caractéristiques d’une veste : Veste de randonnée, membrane imperméable, poids de 420 grammes, capuche réglable, coutures étanchées. Le système pourrait produire une description convaincante, mais également ajouter une propriété qui ne figure pas dans les informations fournies : une résistance garantie à des températures de -15 °C, par exemple.
Cette affirmation peut sembler cohérente avec le type de produit, sans être justifiée. C’est l’un des problèmes caractéristiques des modèles génératifs, souvent désigné sous le terme d’hallucination. Le National Institute of Standards and Technology (NIST) utilise plus précisément le terme de confabulation pour désigner la production de contenus erronés présentés avec assurance.
Pour réduire ces risques, notre boutique peut fournir au modèle des informations issues d’une base de produits vérifiée et lui imposer des contraintes de rédaction. Cette architecture peut notamment utiliser une technique appelée Retrieval-Augmented Generation (RAG), qui consiste à récupérer des informations dans des sources externes avant de générer une réponse.
Mais l’accès à des informations fiables n’élimine pas toutes les erreurs possibles. Le système peut encore mal interpréter une caractéristique ou produire une affirmation insuffisamment fondée. La publication automatique de fiches produits implique donc de mettre en place des contrôles adaptés, particulièrement lorsque les descriptions comportent des engagements techniques ou commerciaux.
Dans la pratique, plusieurs approches peuvent coexister
Notre boutique possède maintenant plusieurs applications de l’intelligence artificielle. Pour conseiller les clients, elle utilise des règles explicites. Pour anticiper les ventes, elle mobilise un modèle statistique. Pour identifier les catégories de produits sur les photographies, elle utilise un réseau de neurones profond. Pour rédiger ses fiches, elle fait appel à un modèle génératif.
Des outils qui se complètent
Rien n’oblige toutefois ces systèmes à fonctionner indépendamment. Imaginons un assistant conversationnel chargé de conseiller les clients. Un utilisateur lui indique :
« Je pars trois jours dans les Vosges en novembre. Je cherche une veste légère, adaptée à la pluie, avec un budget maximum de 150 euros.«
L’assistant pourrait utiliser plusieurs composants :
- Un modèle de langage pour interpréter la demande et formuler une réponse compréhensible.
- Une base de connaissances et des règles explicites pour identifier les caractéristiques techniques nécessaires et respecter le budget.
- Un système de recommandation fondé sur le machine learning pour classer les produits pertinents selon les préférences observées des clients.
Le modèle de langage pourrait présenter les avantages des différents produits, mais les prix, les disponibilités et les caractéristiques techniques seraient récupérés dans les systèmes de gestion de la boutique. Une telle architecture associe plusieurs technologies, chacune intervenant sur une partie du problème.
C’est également une manière de limiter les risques liés à l’utilisation exclusive d’un modèle génératif pour prendre des décisions qui nécessitent des informations exactes.
Comment choisir une approche adaptée ?
Le choix dépend d’abord de la nature du problème, des données disponibles et du niveau de fiabilité attendu.
| Besoin de la boutique | Approche envisageable | Condition importante |
|---|---|---|
| Conseiller un équipement selon des critères techniques précis | IA symbolique, règles métiers | Disposer de connaissances fiables et régulièrement actualisées |
| Prévoir les ventes | Machine learning supervisé | Posséder un historique pertinent et des données suffisamment représentatives |
| Identifier différents profils de clientèle | Apprentissage non supervisé | Vérifier que les regroupements obtenus ont un intérêt commercial |
| Optimiser une succession de décisions | Apprentissage par renforcement | Définir une récompense pertinente et maîtriser les conséquences des expérimentations |
| Reconnaître des produits sur des photographies | Deep learning | Disposer d’un modèle adapté aux images et aux catégories recherchées |
| Rédiger des fiches produits | IA générative | S’appuyer sur des informations vérifiées et contrôler les affirmations produites |
Ce tableau ne constitue évidemment pas une correspondance exclusive entre les besoins et les technologies. Un système de recommandation peut utiliser des règles, des algorithmes statistiques ou des réseaux de neurones. Il peut même combiner les trois. De la même manière, une prévision de ventes peut être réalisée avec des méthodes statistiques classiques sans qu’il soit nécessaire de développer un système d’IA particulièrement sophistiqué.
La question des coûts mérite également d’être considérée. Il faut prendre en compte l’intégration aux logiciels existants, la qualité des données, la maintenance, les ressources de calcul et les dispositifs de contrôle. Un modèle techniquement performant peut devenir économiquement peu intéressant si son fonctionnement nécessite davantage de travail pour préparer les données et vérifier les résultats que la tâche qu’il devait automatiser.
Mon point de vue : se méfier de la fascination pour les modèles les plus puissants
L’engouement pour l’IA générative conduit parfois à envisager les grands modèles de langage comme des solutions universelles. Je trouve cette tendance assez discutable. Les capacités de ces modèles sont impressionnantes, mais leur polyvalence peut masquer le fait que certaines tâches exigent surtout des règles explicites, des données fiables ou des calculs relativement simples.
Pour reprendre notre exemple, il serait assez absurde de confier à un modèle de langage la responsabilité de deviner le prix d’une veste, de déterminer ses caractéristiques techniques ou de calculer les frais de livraison. Ces informations doivent provenir de systèmes qui les connaissent et peuvent les garantir.
À l’inverse, utiliser un ensemble de règles figées pour interpréter toutes les demandes formulées librement par les clients serait probablement peu satisfaisant.
Les systèmes les plus intéressants sont souvent ceux qui combinent intelligemment plusieurs approches, en exploitant chacune pour ce qu’elle sait effectivement faire. Cela suppose de conserver une certaine indépendance vis-à-vis des modes technologiques. Le deep learning n’a pas rendu l’IA symbolique inutile, pas plus que l’IA générative n’a supprimé l’intérêt des méthodes statistiques traditionnelles.
Pour les entreprises, la connaissance des grandes familles d’intelligence artificielle constitue donc un outil de discernement. Elle permet de mieux discuter avec les fournisseurs, de comprendre les architectures proposées et d’identifier les risques associés aux différentes solutions.
Et parfois, elle permet simplement de constater qu’un bon logiciel classique fera parfaitement l’affaire.


Laisser un commentaire
Vous devez vous connecter pour publier un commentaire.